
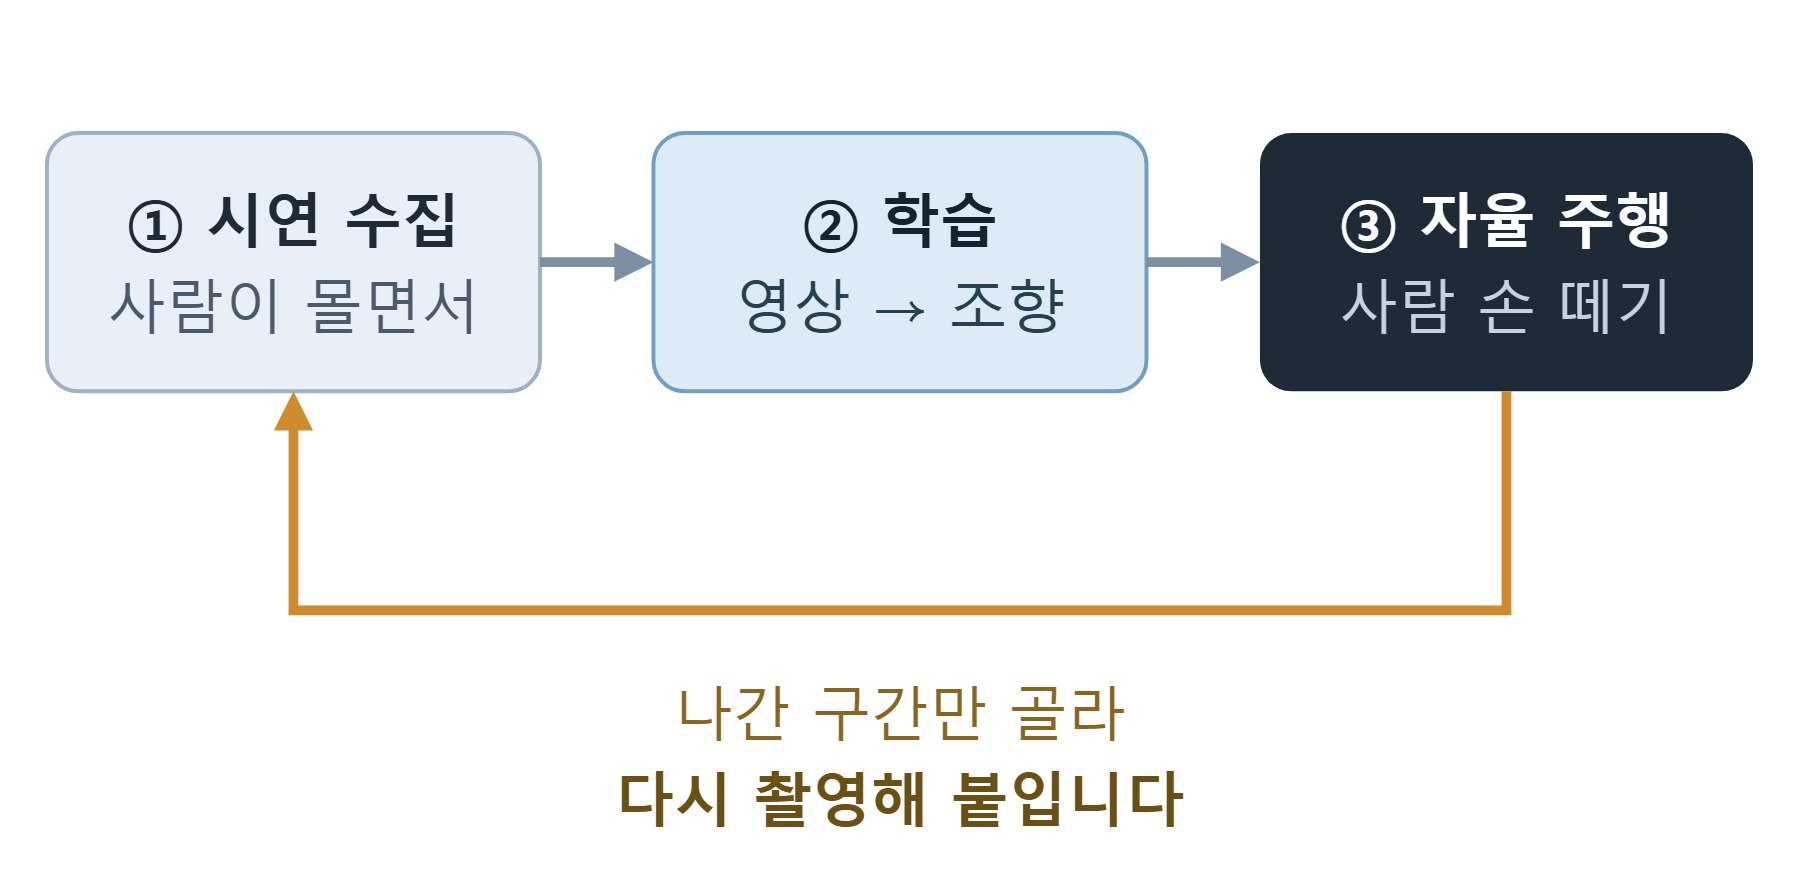
2부의 추적기는 "표적을 화면 가운데로"라는 규칙을 사람이 직접 적어 넣은 것이었습니다. 그런데 "이 복도를 따라 달려라"는 규칙으로 적을 수가 없습니다. 이번에는 규칙을 적는 대신, 사람이 직접 몰아 보여주고 그걸 신경망이 흉내 내게 만듭니다.
규칙 대신 시연을 보여 주는 방식
행동 복제(behavior cloning)는 구조가 단순합니다. 사람이 조종하는 동안 (그 순간의 카메라 영상, 그 순간의 조향값) 쌍을 계속 저장합니다. 그리고 영상을 넣으면 조향값이 나오는 함수를 신경망으로 근사합니다. 보상 함수를 설계할 필요도, 시뮬레이터를 붙일 필요도 없습니다. 대신 사람이 보여준 데이터의 품질이 그대로 성능이 됩니다.
미니카 하드웨어
2부의 PCA9685를 그대로 재사용합니다. 다른 점은 서보 대신 DC 모터를 굴린다는 것이고, DC 모터는 방향을 바꿔야 하므로 모터 드라이버가 하나 더 붙습니다.
| 부품 | 용도 | 비고 |
|---|---|---|
| 2륜 구동 로봇 섀시 | 바퀴, 모터, 캐스터 | 기어드 DC 모터 6V급 2개 |
| TB6612FNG 모터 드라이버 | 방향 전환과 전류 공급 | L298N보다 효율이 좋고 발열이 적습니다 |
| PCA9685 (2부에서 쓰던 것) | 모터 속도용 PWM | 주파수를 1kHz로 바꿉니다 |
| 18650 2셋 또는 7.4V 리포 | 모터 전원 | 젯슨 전원과 분리 |
| 보조 배터리 (5V 5A 출력) | 젯슨 전원 | 출력이 부족하면 주행 중 재부팅됩니다 |
| CSI 카메라 (IMX219) | 전방 영상 | 광각 렌즈면 코너를 더 일찍 봅니다 |
배선은 다음과 같습니다. 방향 핀은 PWM이 필요 없으므로 젯슨 GPIO로 직접 씁니다.
| TB6612FNG 핀 | 연결 대상 |
|---|---|
| PWMA / PWMB | PCA9685 채널 0 / 채널 1 |
| AIN1 / AIN2 | 젯슨 29번 / 31번 핀 |
| BIN1 / BIN2 | 젯슨 32번 / 33번 핀 |
| STBY | 젯슨 35번 핀 |
| VM | 모터 배터리 + (6~12V) |
| VCC | 젯슨 1번 핀 (3.3V) |
| GND | 젯슨 GND, 배터리 −, PCA9685 GND 공통 |
# motor.py — PCA9685(속도) + TB6612FNG(방향) 으로 2륜 차동 구동
import atexit

import board
import busio
import Jetson.GPIO as GPIO
from adafruit_pca9685 import PCA9685

I2C = busio.I2C(board.SCL_1, board.SDA_1)

PIN_AIN1, PIN_AIN2 = 29, 31        # BOARD 번호
PIN_BIN1, PIN_BIN2 = 32, 33
PIN_STBY = 35


class Chassis:
    """steer(-1 왼쪽 ~ +1 오른쪽) 와 throttle(0~1) 로 두 바퀴를 굴린다."""

    def __init__(self, freq=1000, ch_left=0, ch_right=1, trim=0.0, max_duty=0.45):
        self.pca = PCA9685(I2C, address=0x40)
        # 서보는 50Hz 였지만 DC 모터는 1kHz 근처를 쓴다. 낮으면 저속에서 덜덜거린다
        self.pca.frequency = freq
        self.ch_l, self.ch_r = ch_left, ch_right
        self.trim = trim            # 좌우 모터 개체차 보정. 직진이 휘면 여기를 만진다
        self.max_duty = max_duty    # 실내 주행에서 이보다 빠르면 코너를 못 잡는다

        GPIO.setmode(GPIO.BOARD)
        for p in (PIN_AIN1, PIN_AIN2, PIN_BIN1, PIN_BIN2, PIN_STBY):
            GPIO.setup(p, GPIO.OUT, initial=GPIO.LOW)
        GPIO.output(PIN_STBY, GPIO.HIGH)
        atexit.register(self.stop)

    def _wheel(self, ch, in1, in2, value):
        GPIO.output(in1, GPIO.HIGH if value >= 0 else GPIO.LOW)
        GPIO.output(in2, GPIO.LOW if value >= 0 else GPIO.HIGH)
        duty = min(abs(value), self.max_duty)
        self.pca.channels[ch].duty_cycle = int(duty * 0xFFFF)

    def set(self, steer, throttle):
        steer = max(-1.0, min(1.0, steer))
        throttle = max(0.0, min(1.0, throttle))
        left = throttle * (1.0 + steer) + self.trim
        right = throttle * (1.0 - steer) - self.trim
        self._wheel(self.ch_l, PIN_AIN1, PIN_AIN2, left)
        self._wheel(self.ch_r, PIN_BIN1, PIN_BIN2, right)

    def stop(self):
        for ch in (self.ch_l, self.ch_r):
            self.pca.channels[ch].duty_cycle = 0
        GPIO.output(PIN_STBY, GPIO.LOW)     # 드라이버를 대기 상태로
처음 켤 때는 바퀴를 바닥에서 띄워 놓고 Chassis().set(0, 0.3) 을 실행하세요. 두 바퀴가 같은 방향으로 도는지, 왼쪽이 왼쪽인지부터 확인해야 합니다. 반대로 돌면 모터 선 두 가닥을 바꿔 끼우면 됩니다.
데이터 수집
키보드로는 부드러운 조향을 만들 수 없습니다. 게임패드의 아날로그 스틱을 씁니다. 리눅스에서는 evdev 로 읽는 게 가장 단순합니다.
sudo pip3 install evdev
ls /dev/input/event*        # 패드를 꽂았다 뺐다 하면서 어느 게 늘어나는지 본다
# collect.py — 게임패드로 몰면서 (이미지, 조향, 속도) 를 저장한다
import csv
import os
import time
from pathlib import Path

import cv2
from evdev import InputDevice, ecodes, list_devices

from camera import open_camera      # 1부에서 만든 파일
from motor import Chassis

RATE_HZ = 20                        # 초당 저장 프레임 수
SESSION = Path("data") / time.strftime("%m%d_%H%M")
(SESSION / "frames").mkdir(parents=True, exist_ok=True)


def find_gamepad():
    for path in list_devices():
        dev = InputDevice(path)
        if ecodes.EV_ABS in dev.capabilities():
            print(f"게임패드: {dev.name} ({path})")
            return dev
    raise RuntimeError("게임패드를 찾지 못했습니다.")


pad = find_gamepad()
pad.grab()                          # 다른 프로그램이 못 가져가게 잡아 둔다
os.set_blocking(pad.fd, False)

ax = pad.absinfo(ecodes.ABS_X)      # 스틱 좌우
az = pad.absinfo(ecodes.ABS_RZ)     # 오른쪽 트리거 = 가속

cam = open_camera("csi", out_w=320, out_h=240)
car = Chassis()

steer, throttle, armed, recording = 0.0, 0.0, False, False
rows = []
period = 1.0 / RATE_HZ


def norm(v, info, dead=0.10):
    x = (v - (info.min + info.max) / 2) / ((info.max - info.min) / 2)
    return 0.0 if abs(x) < dead else x      # 스틱 중립 흔들림을 죽인다


try:
    while True:
        t0 = time.time()
        try:
            for e in pad.read():
                if e.type == ecodes.EV_ABS and e.code == ecodes.ABS_X:
                    steer = norm(e.value, ax)
                elif e.type == ecodes.EV_ABS and e.code == ecodes.ABS_RZ:
                    throttle = (e.value - az.min) / (az.max - az.min)
                elif e.type == ecodes.EV_KEY:
                    if e.code == ecodes.BTN_TL:            # LB 를 누르고 있어야 움직인다
                        armed = bool(e.value)
                    elif e.code == ecodes.BTN_SOUTH and e.value == 1:
                        recording = not recording
                        print("기록 " + ("시작" if recording else "정지"))
                    elif e.code == ecodes.BTN_EAST and e.value == 1:
                        raise KeyboardInterrupt
        except BlockingIOError:
            pass

        ok, frame = cam.read()
        if not ok:
            continue

        car.set(steer if armed else 0.0, throttle if armed else 0.0)

        # 멈춰 있는 장면은 저장하지 않는다. 정지 프레임이 많으면 모델이 안 굴러간다
        if recording and armed and throttle > 0.15:
            name = f"{len(rows):06d}.jpg"
            cv2.imwrite(str(SESSION / "frames" / name), frame,
                        [cv2.IMWRITE_JPEG_QUALITY, 90])
            rows.append({"file": name, "steer": round(steer, 4),
                         "throttle": round(throttle, 4)})

        time.sleep(max(0.0, period - (time.time() - t0)))

except KeyboardInterrupt:
    pass
finally:
    car.stop()
    pad.ungrab()
    with open(SESSION / "labels.csv", "w", newline="") as f:
        w = csv.DictWriter(f, fieldnames=["file", "steer", "throttle"])
        w.writeheader()
        w.writerows(rows)
    print(f"{len(rows)} 프레임 저장: {SESSION}")
한 바퀴 30초짜리 실내 트랙이라면 20Hz로 열 바퀴를 돌면 6천 장 정도가 모입니다. 그 정도가 하나의 트랙을 학습시키는 출발선입니다. 대신 한 방향으로만 열 바퀴를 돌지 마세요. 시계 방향으로 다섯 바퀴, 반시계로 다섯 바퀴를 돌아야 합니다.
데이터가 한쪽으로 몰리면 학습이 망합니다
수집을 끝냈으면 학습을 돌리기 전에 조향값 히스토그램부터 그려 보세요. 실내 트랙에서는 거의 항상 직진 구간이 코너보다 깁니다. 그래서 조향값이 0 근처에 몰립니다. 이 데이터로 학습하면 모델은 "무슨 그림이 들어와도 0을 뱉는 것"이 가장 손실이 작다는 걸 배웁니다. 직진은 완벽한데 첫 코너에서 그대로 벽으로 갑니다.
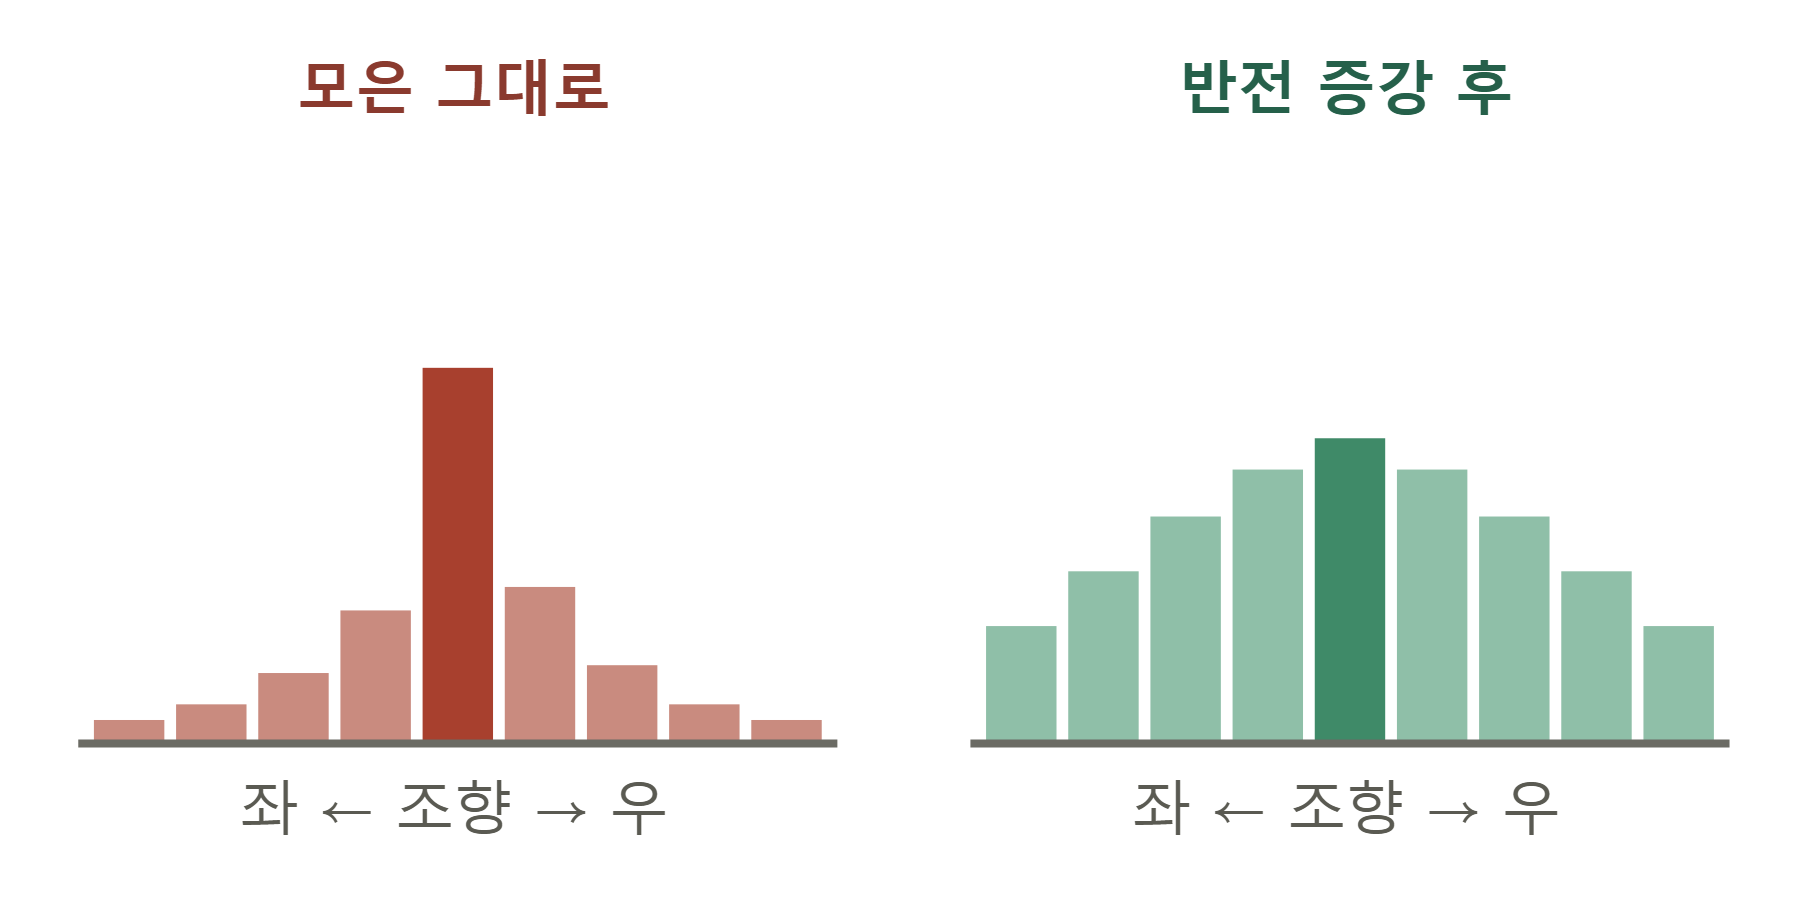
대응은 세 가지입니다.
- 좌우 반전 증강. 이미지를 좌우로 뒤집고 조향값의 부호도 뒤집습니다. 공짜로 데이터가 두 배가 되고 좌우 편향이 정확히 0이 됩니다. 아래 학습 코드에 넣어 두었습니다.
- 정지 프레임 제외. 수집 코드에서
throttle > 0.15조건으로 이미 걸렀습니다. - 코너 구간 추가 촬영. 헤어핀 하나가 유난히 어렵다면 그 코너만 여러 번 왕복해서 따로 세션을 만드세요.
학습
파이토치를 젯슨에 깝니다. PyPI의 일반 휠은 젯슨의 CUDA와 맞지 않으므로 젯슨용 인덱스를 씁니다.
# JetPack 6.2 (CUDA 12.6) 기준
python3 -m pip install torch==2.8.0 torchvision==0.23.0 \
    --index-url=https://pypi.jetson-ai-lab.io/jp6/cu126

python3 -c "import torch; print(torch.__version__, torch.cuda.is_available())"
# 2.8.0 True 가 나와야 한다
# train.py — ResNet-18 을 조향 회귀로 미세조정한다
import csv
from pathlib import Path

import torch
import torch.nn as nn
from PIL import Image
from torch.utils.data import DataLoader, Dataset, random_split
from torchvision import transforms
from torchvision.models import ResNet18_Weights, resnet18

IMG = 224
EPOCHS = 30
BATCH = 32
DEV = "cuda" if torch.cuda.is_available() else "cpu"
NORM = transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])

train_tf = transforms.Compose([
    transforms.Resize((IMG, IMG)),
    # 조명이 바뀌면 그대로 무너지는 것을 막는다. 실습에서 제일 효과가 큰 증강이다
    transforms.ColorJitter(0.4, 0.4, 0.4, 0.05),
    transforms.ToTensor(),
    NORM,
])
eval_tf = transforms.Compose([transforms.Resize((IMG, IMG)),
                             transforms.ToTensor(), NORM])


class DriveSet(Dataset):
    """labels.csv 여러 개를 한 번에 읽고, 좌우 반전본을 뒤쪽에 덧붙인다."""

    def __init__(self, roots, tf, flip=True):
        self.items, self.tf, self.flip = [], tf, flip
        for root in roots:
            root = Path(root)
            with open(root / "labels.csv") as f:
                for r in csv.DictReader(f):
                    self.items.append((root / "frames" / r["file"],
                                       float(r["steer"]), float(r["throttle"])))

    def __len__(self):
        return len(self.items) * (2 if self.flip else 1)

    def __getitem__(self, i):
        n = len(self.items)
        path, steer, thr = self.items[i % n]
        img = Image.open(path).convert("RGB")
        if self.flip and i >= n:
            img = img.transpose(Image.FLIP_LEFT_RIGHT)
            steer = -steer          # 화면을 뒤집었으니 조향 부호도 뒤집는다
        return self.tf(img), torch.tensor([steer, thr], dtype=torch.float32)


def build_model():
    m = resnet18(weights=ResNet18_Weights.IMAGENET1K_V1)
    m.fc = nn.Linear(m.fc.in_features, 2)      # (조향, 속도) 두 개를 회귀한다
    return m


def main(roots):
    full = DriveSet(roots, train_tf)
    n_val = max(1, int(len(full) * 0.15))
    train_set, val_set = random_split(full, [len(full) - n_val, n_val],
                                      generator=torch.Generator().manual_seed(0))
    train_dl = DataLoader(train_set, BATCH, shuffle=True, num_workers=4, pin_memory=True)
    val_dl = DataLoader(val_set, BATCH, shuffle=False, num_workers=2)

    model = build_model().to(DEV)
    opt = torch.optim.AdamW(model.parameters(), lr=3e-4, weight_decay=1e-4)
    sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, EPOCHS)
    # MSE 는 튄 라벨 하나에 크게 흔들린다. SmoothL1 이 사람 조종 데이터에 잘 맞는다
    crit = nn.SmoothL1Loss(beta=0.1)
    scaler = torch.amp.GradScaler("cuda")

    best = float("inf")
    for ep in range(1, EPOCHS + 1):
        model.train()
        tr = 0.0
        for x, y in train_dl:
            x, y = x.to(DEV, non_blocking=True), y.to(DEV, non_blocking=True)
            opt.zero_grad(set_to_none=True)
            with torch.amp.autocast("cuda"):
                loss = crit(model(x), y)
            scaler.scale(loss).backward()
            scaler.step(opt)
            scaler.update()
            tr += loss.item() * x.size(0)
        sched.step()

        model.eval()
        va = 0.0
        with torch.no_grad():
            for x, y in val_dl:
                x, y = x.to(DEV), y.to(DEV)
                va += crit(model(x), y).item() * x.size(0)
        tr, va = tr / len(train_set), va / len(val_set)
        print(f"epoch {ep:2d}  train {tr:.4f}  val {va:.4f}")

        if va < best:
            best = va
            torch.save(model.state_dict(), "steer_best.pt")
            print(f"  저장 (val {va:.4f})")


if __name__ == "__main__":
    import sys
    main(sys.argv[1:] or ["data/0101_1200"])
검증 손실이 학습 손실보다 눈에 띄게 크면서 계속 벌어지면 과적합입니다. 데이터를 더 모으는 게 정답이지, 에폭을 늘리는 게 정답이 아닙니다. 반대로 둘 다 내려가지 않으면 라벨이 잘못 붙었을 가능성이 큽니다. labels.csv 의 조향값과 같은 인덱스의 프레임을 몇 장 눈으로 대조해 보세요.
배포
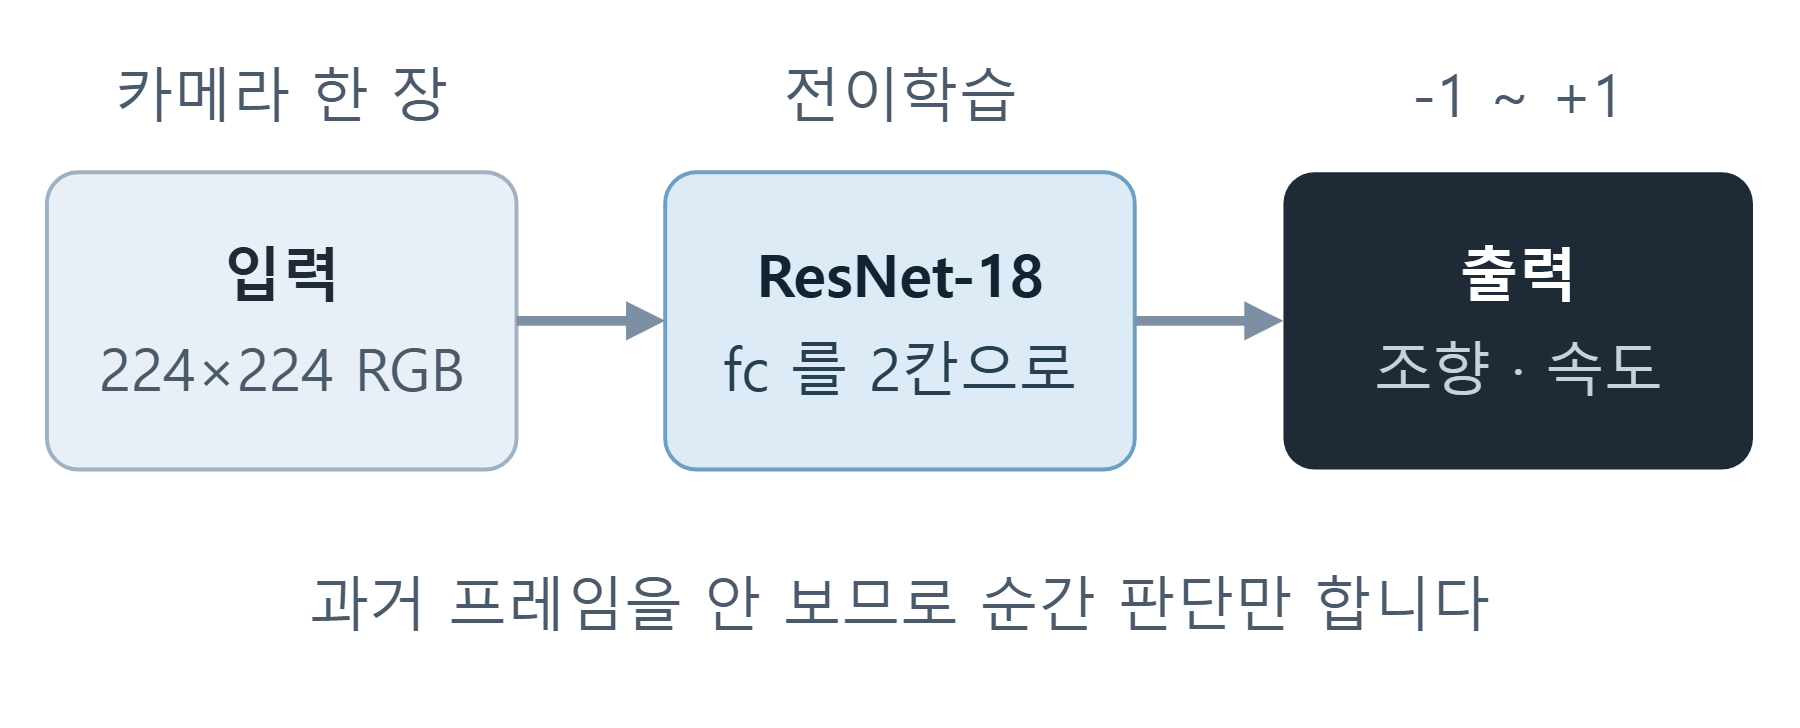
주행 코드에는 반드시 데드맨 스위치를 넣습니다. 게임패드 버튼을 누르고 있는 동안만 달리고, 손을 떼면 즉시 멈춥니다. 미니카는 생각보다 빠르고, 노트북까지 뛰어가서 Ctrl+C를 누를 시간이 없습니다.
# drive.py — 학습한 정책으로 사람 없이 달린다
import os
import time

import cv2
import torch
from evdev import InputDevice, ecodes, list_devices

from camera import open_camera
from motor import Chassis
from train import build_model

DEV = "cuda"
MEAN = torch.tensor([0.485, 0.456, 0.406], device=DEV).view(3, 1, 1)
STD = torch.tensor([0.229, 0.224, 0.225], device=DEV).view(3, 1, 1)
THROTTLE = 0.30       # 처음에는 이보다 올리지 마세요
STEER_GAIN = 1.0
SMOOTH = 0.5          # 조향 지수 평활

model = build_model()
model.load_state_dict(torch.load("steer_best.pt", map_location=DEV))
model.eval().half().to(DEV)


def preprocess(frame):
    img = cv2.cvtColor(cv2.resize(frame, (224, 224)), cv2.COLOR_BGR2RGB)
    t = torch.from_numpy(img).to(DEV).permute(2, 0, 1).float().div_(255.0)
    return ((t - MEAN) / STD).unsqueeze(0).half()


pad = next(InputDevice(p) for p in list_devices()
           if ecodes.EV_KEY in InputDevice(p).capabilities())
os.set_blocking(pad.fd, False)

cam = open_camera("csi", out_w=320, out_h=240)
car = Chassis()
armed, steer, n, t0 = False, 0.0, 0, time.time()

try:
    while True:
        try:
            for e in pad.read():
                if e.type == ecodes.EV_KEY and e.code == ecodes.BTN_TL:
                    armed = bool(e.value)       # LB 를 누르고 있는 동안만 달린다
                    if not armed:
                        car.stop()
        except BlockingIOError:
            pass

        ok, frame = cam.read()
        if not ok:
            continue

        with torch.no_grad():
            out = model(preprocess(frame))[0].float().cpu()
        raw = float(out[0]) * STEER_GAIN
        steer = SMOOTH * raw + (1 - SMOOTH) * steer     # 급조향을 눌러 준다

        car.set(steer if armed else 0.0, THROTTLE if armed else 0.0)

        n += 1
        if n % 60 == 0:
            print(f"{n / (time.time() - t0):5.1f} fps   steer {steer:+.2f}   "
                  f"{'RUN' if armed else 'HOLD'}")
finally:
    car.stop()
    print("정지")
ResNet-18을 224×224 FP16으로 돌리는 것은 오린 나노에서 가벼운 축입니다. 카메라의 30fps를 넘기고도 여유가 남는 것이 정상이며, 만약 20fps 아래로 떨어진다면 전력 모드부터 확인하세요(1부의 nvpmodel -m 2). 실제 수치는 drive.py 가 60프레임마다 찍어 주는 값으로 직접 확인하면 됩니다.
더 짜내고 싶다면 TensorRT로 변환합니다. 우선 얼마나 남아 있는지부터 재 보세요.
# export_onnx.py
import torch
from train import build_model

m = build_model()
m.load_state_dict(torch.load("steer_best.pt", map_location="cpu"))
m.eval()
torch.onnx.export(m, torch.randn(1, 3, 224, 224), "steer.onnx",
                  input_names=["input"], output_names=["control"], opset_version=17)
# TensorRT 로 돌렸을 때의 상한을 먼저 측정한다
/usr/src/tensorrt/bin/trtexec --onnx=steer.onnx --fp16 --shapes=input:1x3x224x224
trtexec 가 뱉는 지연 시간이 지금 파이토치 추론 시간과 큰 차이가 없다면 변환할 이유가 없습니다. 병목이 추론이 아니라 카메라나 JPEG 저장 쪽에 있을 가능성이 큽니다.
실패 구간만 다시 모으는 것이 핵심입니다
첫 학습 결과는 대개 트랙의 80퍼센트를 돌고 특정 코너에서 나갑니다. 여기서 데이터를 전부 다시 모으면 안 됩니다. 나간 지점만 다시 촬영해서 새 세션 폴더로 만들고, 기존 세션과 함께 학습하세요.
python3 collect.py                      # 실패한 코너만 왕복하며 촬영
python3 train.py data/0101_1200 data/0101_1430
이 방식이 효과적인 이유는 분포가 어긋나기 때문입니다. 사람이 몰 때는 트랙 중앙만 지나가므로, 차가 살짝 벗어난 상황의 그림이 데이터에 없습니다. 그런데 자율 주행 중에는 반드시 그런 상황이 생기고, 모델은 본 적 없는 그림 앞에서 아무 말이나 합니다. 그래서 일부러 트랙 가장자리에서 중앙으로 복귀하는 장면을 몇 번 찍어 넣으면 성능이 눈에 띄게 올라갑니다. 연구 쪽에서 DAgger라고 부르는 절차의 가장 단순한 형태입니다.
성공률은 감으로 말하지 말고 세어서 기록하세요. "한 바퀴 완주 10회 중 몇 번"을 매번 적어 두면 어떤 조치가 실제로 효과가 있었는지 알 수 있습니다.
안전 수칙
| 항목 | 지킬 것 |
|---|---|
| 첫 실행 | 바퀴를 책 두 권 위에 올려 띄운 상태에서 |
| 속도 | THROTTLE = 0.30 부터. 잡을 수 있는 속도로만 |
| 정지 | 데드맨 스위치 필수. finally 에서 car.stop() |
| 배터리 | 리포는 부풀거나 찌그러지면 즉시 폐기, 충전 중 자리 비우지 않기 |
| 장소 | 계단·문턱 없는 실내, 주변에 사람 발이 없는 곳 |
| 전원 | 젯슨과 모터 배터리를 분리. 안 그러면 주행 중 재부팅됩니다 |
여기서 어디로 갈 수 있나
이 3부작으로 만든 것은 카메라 한 장을 보고 조향 하나를 내놓는 정책입니다. 다음 단계는 세 방향입니다.
- 관측을 늘리기: 프레임 한 장 대신 최근 N장을 쌓아 넣으면 속도 정보가 들어갑니다. IMU나 거리 센서를 붙이면 상태가 훨씬 풍부해집니다.
- 구조를 갖추기: 노드와 토픽으로 나누는 ROS 2, 그 위의 NVIDIA Isaac ROS로 넘어가면 SLAM과 내비게이션을 얹을 수 있습니다.
- 모델을 키우기: 로봇 팔로 넘어가면 허깅페이스 LeRobot 의 ACT나 Diffusion Policy 같은 정책을 그대로 써 볼 수 있습니다. 이 시리즈에서 배운 "데이터 수집 절차가 성능을 결정한다"는 교훈이 거기서도 똑같이 적용됩니다.
당장 할 일은 하나입니다. 오늘 모은 데이터로 학습한 모델을 돌려서 어느 지점에서 나가는지 기록하고, 그 지점만 다시 촬영해 붙인 뒤 성공률이 얼마나 변했는지 숫자로 적어 보세요. 피지컬 AI 프로젝트의 실력은 모델을 바꾸는 데서가 아니라 이 반복에서 늘어납니다.
참고 자료
'인공지능 AI' 카테고리의 다른 글
| HBM4 공급 경쟁과 AI 반도체 패키징 판도 (0) | 2026.09.15 |
|---|---|
| 에이전틱 AI 도입 동향과 프로젝트 취소 전망 (0) | 2026.09.15 |
| 젯슨 나노 피지컬 AI 2부 - 팬틸트 카메라 사람 추적 (0) | 2026.09.08 |
| 젯슨 나노 피지컬 AI 1부 - 보드 선택과 실시간 검출 (0) | 2026.09.08 |
| AI 모방학습 준비와 절차 - LeRobot 기준 (0) | 2026.08.28 |