
허깅페이스 LeRobot 공식 문서에는 이런 문장이 있습니다. "25개 에피소드로도 비슷한 데이터셋을 만들어봤는데, 부족해서 성능이 나빴습니다." 같은 작업, 같은 모델인데 시연 개수 하나로 갈렸다는 뜻입니다. 모방학습을 시작할 때 먼저 챙겨야 할 것은 모델이 아니라 데이터 수집 절차입니다.
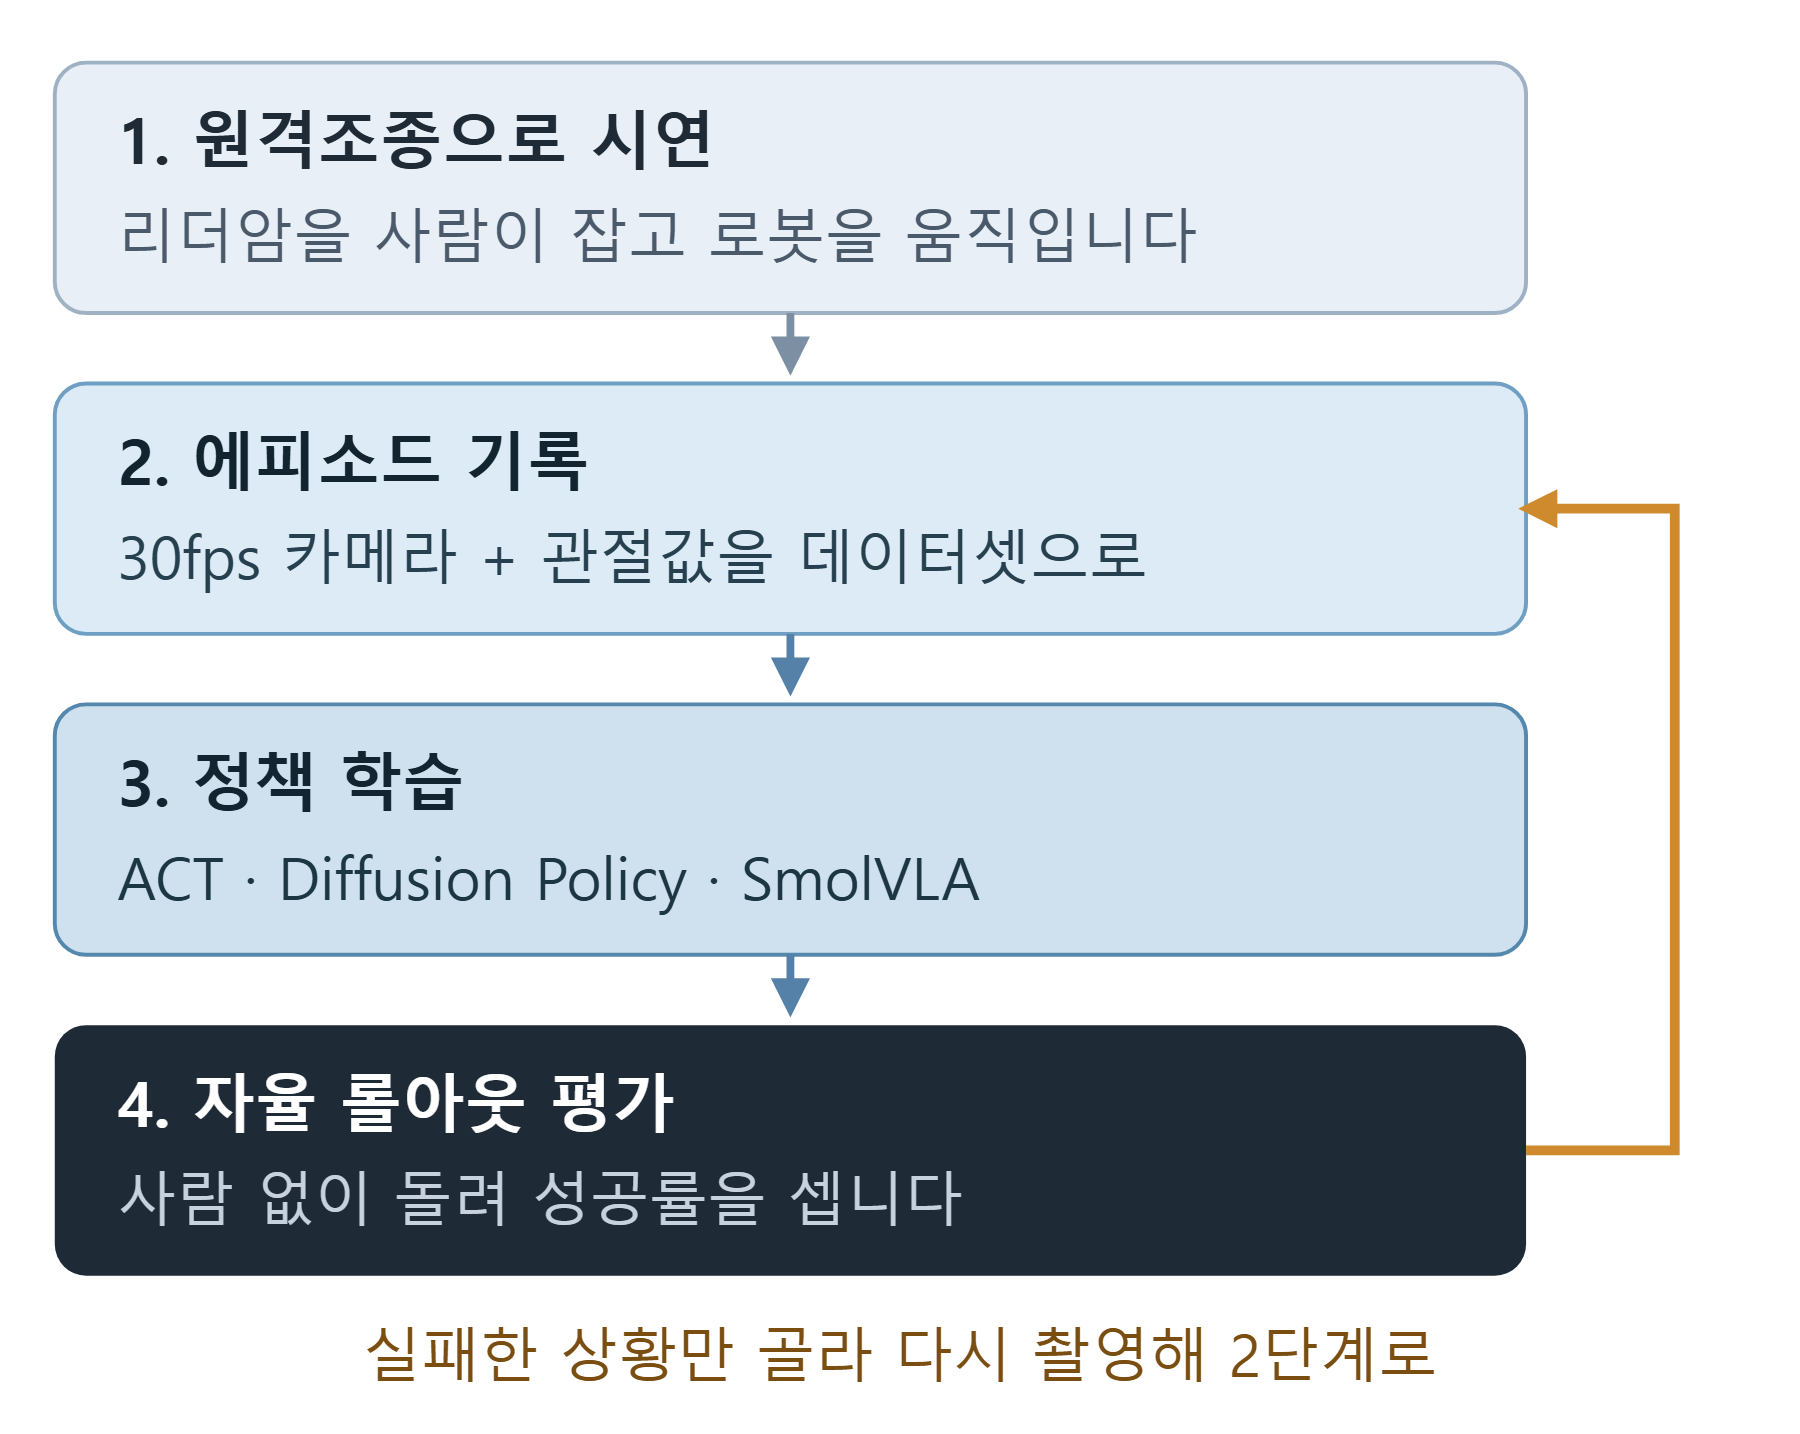
모방학습은 결국 이 네 단계입니다
모방학습(imitation learning)은 사람이 로봇을 직접 조종해 보여준 궤적을 신경망이 따라 하게 만드는 방식입니다. 강화학습처럼 보상 함수를 설계할 필요가 없고, 대신 사람이 보여준 데이터의 품질이 그대로 성능이 됩니다.
0단계: 준비물부터 정합니다
LeRobot 논문에는 지원 플랫폼과 대략적인 부품 비용이 정리되어 있습니다. 처음 시작한다면 SO-101이 사실상 표준입니다. 커뮤니티 데이터셋의 절반 이상이 SO-10X 계열에서 나왔기 때문에, 막혔을 때 참고할 사례가 가장 많습니다.
| 플랫폼 | 대략 비용 | 성격 |
|---|---|---|
| SO-100 / SO-101 | 단일 약 225유로, 양팔 약 550유로 | 입문 표준. 3D 프린트 + 다이나믹셀급 서보 |
| LeKiwi | 약 230유로 | 바퀴 달린 모바일 매니퓰레이터 |
| Hope-JR | 약 500유로 | 휴머노이드 형태 팔 |
| Koch v1.1 | 단일 약 670유로, 양팔 약 1,346유로 | SO-101 상위 |
| ALOHA-2 | 약 2만 1천 유로 | 연구실용 양팔 정밀 플랫폼 |
여기에 USB 카메라 두 대(손목 하나, 전체 시야 하나)와 GPU가 필요합니다. 학습은 로컬 GPU가 없으면 Colab이나 클라우드로 돌려도 됩니다. 다만 데이터 수집과 평가는 로봇이 물리적으로 있어야 하므로 원격으로 대체할 수 없습니다.
1단계: 캘리브레이션과 원격조종 확인
리더암과 팔로워암을 연결하고 먼저 조종만 해봅니다. 여기서 --robot.id에 지정한 이름으로 캘리브레이션 파일이 저장되므로, 이후 기록·학습·평가에서 같은 이름을 계속 써야 합니다. 이름을 바꾸면 캘리브레이션이 어긋나 로봇이 엉뚱한 각도로 움직입니다.
lerobot-teleoperate \
    --robot.type=so101_follower \
    --robot.port=/dev/ttyACM0 \
    --robot.id=my_follower_arm \
    --robot.cameras="{front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30}}" \
    --teleop.type=so101_leader \
    --teleop.port=/dev/ttyACM1 \
    --teleop.id=my_leader_arm \
    --display_data=true
--display_data=true를 붙이면 카메라 화면과 관절 값이 함께 뜹니다. 이 화면을 보면서 확인할 것이 하나 있습니다. 카메라 이미지만 보고 사람인 내가 이 작업을 해낼 수 있는가. LeRobot 문서가 좋은 데이터셋의 기준으로 제시하는 경험칙입니다. 사람도 그 화면만으로는 물체 위치를 못 잡겠다면, 신경망은 더 못 합니다. 카메라 각도를 여기서 고쳐야 합니다.
2단계: 50개를 찍되, 5개 위치로 나눠 찍습니다
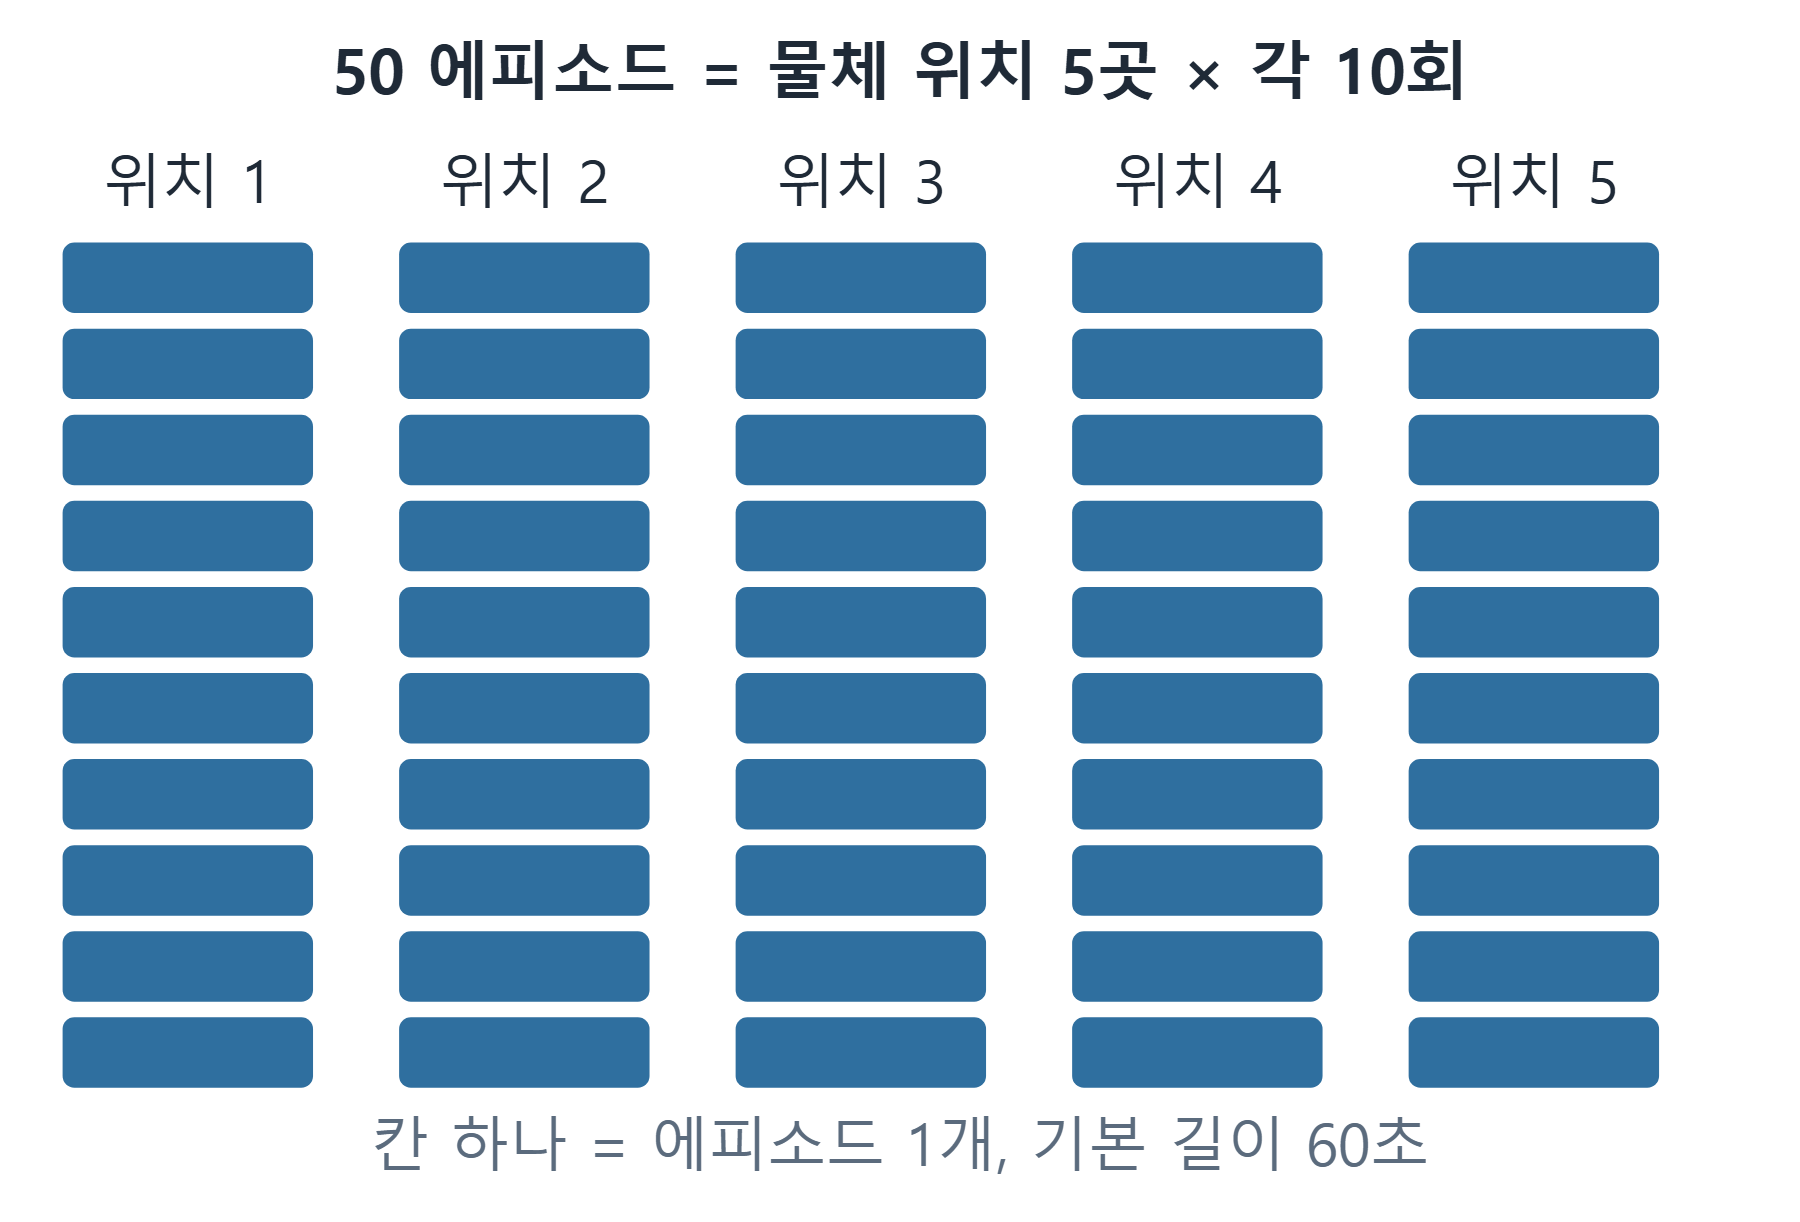
가장 중요한 단계입니다. LeRobot이 권장하는 시작점은 50 에피소드이고, 그냥 50번이 아니라 물체 위치 5곳 × 각 10회입니다. SmolVLA 논문에 쓰인 공개 데이터셋도 정확히 이 구성입니다.
기록 명령은 이렇습니다.
lerobot-record \
    --robot.type=so101_follower \
    --robot.port=/dev/ttyACM0 \
    --robot.id=my_follower_arm \
    --robot.cameras="{front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30}}" \
    --teleop.type=so101_leader \
    --teleop.port=/dev/ttyACM1 \
    --teleop.id=my_leader_arm \
    --dataset.repo_id=${HF_USER}/pick-place-test \
    --dataset.num_episodes=50 \
    --dataset.single_task="Grab the black cube"
기본값은 에피소드당 60초(episode_time_s), 에피소드 사이 환경 리셋 60초(reset_time_s), 총 50개(num_episodes)입니다. 촬영 중에는 키보드로 흐름을 제어합니다. 오른쪽 화살표 또는 n은 현재 에피소드를 조기 종료하고 다음으로, 왼쪽 화살표 또는 r은 방금 것을 버리고 다시 찍기, ESC 또는 q는 즉시 종료하고 영상 인코딩과 업로드를 시작합니다. 실수한 시연을 그냥 남기지 말고 r로 버리는 습관이 성능을 좌우합니다.
촬영 중 지킬 것은 세 가지입니다. 카메라를 절대 움직이지 말 것, 파지 동작을 매번 같은 방식으로 할 것, 조작 대상이 항상 카메라에 보이게 할 것. 변형을 늘리고 싶다면 성공률이 안정된 뒤에 조금씩 추가합니다. 문서도 "변형을 한꺼번에 너무 많이 넣지 말라"고 경고합니다.
3단계: 학습 전에 데이터를 되돌려봅니다
바로 학습에 넣지 말고 lerobot-replay로 기록한 궤적을 로봇에 다시 재생시켜 봅니다. 로봇이 원래 동작을 그대로 재현하지 못한다면 기록 자체가 깨진 것이고, 그 상태로 학습해봐야 시간만 버립니다.
lerobot-replay \
    --robot.type=so101_follower \
    --robot.port=/dev/ttyACM0 \
    --robot.id=my_follower_arm \
    --dataset.repo_id=${HF_USER}/pick-place-test \
    --dataset.episode=0
데이터셋은 로컬 ~/.cache/huggingface/lerobot/{repo-id} 에 저장되고, 허브에 올렸다면 브라우저 뷰어로 프레임 단위 확인도 가능합니다.
4단계: 정책을 고릅니다
여기서 처음으로 모델 선택이 등장합니다. LeRobot 논문에 정리된 규모와 지연 시간을 보면 선택 기준이 분명해집니다.
| 정책 | 파라미터 | 성격 |
|---|---|---|
| ACT | 52M | 액션 청크를 한 번에 예측. 가볍고 빠름. 첫 시도용 |
| Diffusion Policy | 263M | 궤적을 확산 과정으로 생성. CPU 추론이 느림 |
| SmolVLA | 450M | 언어 조건부. 사전학습 가중치를 파인튜닝 |
| π0 | 3.5B | 비전-언어-액션 대형 모델. 자원 요구 큼 |
단일 작업을 확실히 성공시키는 것이 목표라면 ACT부터 시작하는 편이 낫습니다. "저 블록을 집어라" 같은 말로 지시하고 싶다면 SmolVLA 쪽입니다. SmolVLA와 π0처럼 추론이 느린 모델은 롤아웃 시 --inference.type=rtc 옵션으로 실시간 실행을 보정합니다.
5단계: 학습을 돌립니다
ACT로 학습하는 명령입니다.
lerobot-train \
  --dataset.repo_id=${HF_USER}/pick-place-test \
  --policy.type=act \
  --output_dir=outputs/train/act_so101_test \
  --job_name=act_so101_test \
  --policy.device=cuda \
  --wandb.enable=true
SmolVLA를 파인튜닝한다면 사전학습 가중치를 지정합니다. 문서 기준으로 배치 64, 2만 스텝이면 A100 한 장에서 약 4시간이 걸립니다.
lerobot-train \
  --policy.path=lerobot/smolvla_base \
  --dataset.repo_id=${HF_USER}/pick-place-test \
  --batch_size=64 \
  --steps=20000 \
  --output_dir=outputs/train/my_smolvla \
  --policy.device=cuda
배치 크기는 작게 시작해 GPU가 버티는 만큼 올리는 편이 안전합니다. 애플 실리콘이라면 --policy.device=mps입니다. 중단됐다면 체크포인트의 train_config.json을 --config_path로 주고 --resume=true로 이어서 돌립니다.
6단계: 성공률로 판정합니다
평가는 감으로 하지 않고 횟수를 셉니다. lerobot-rollout에 --strategy.type=base를 주면 기록 없이 자율 실행만 하고, --strategy.type=sentry를 주면 평가 장면을 계속 기록해 데이터셋으로 남깁니다. 기록해두면 어떤 상황에서 실패하는지 나중에 프레임 단위로 볼 수 있습니다.
lerobot-rollout \
  --strategy.type=base \
  --policy.path=${HF_USER}/my_policy \
  --robot.type=so101_follower \
  --robot.port=/dev/ttyACM0 \
  --robot.cameras="{front: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30}}" \
  --task="Grab the black cube" \
  --duration=60
--task에 넣는 문장은 데이터를 기록할 때 쓴 single_task 문장과 글자까지 같아야 합니다. 언어 조건부 모델에서 이게 어긋나면 성능이 뚝 떨어집니다.
다음에 할 일
지금 로봇이 없더라도 오늘 해볼 수 있는 것이 있습니다. 허깅페이스 허브에서 LeRobot 태그가 달린 공개 데이터셋 하나를 골라 뷰어로 열고, 에피소드 열 개를 처음부터 끝까지 넘겨보십시오. 좋은 시연이 어떻게 생겼는지 눈에 익히는 것이 첫 촬영에서 가장 크게 아끼는 시간입니다.
참고 자료
'인공지능 AI' 카테고리의 다른 글
| 젯슨 나노 피지컬 AI 2부 - 팬틸트 카메라 사람 추적 (0) | 2026.09.08 |
|---|---|
| 젯슨 나노 피지컬 AI 1부 - 보드 선택과 실시간 검출 (0) | 2026.09.08 |
| 피지컬 AI, 개념과 2026년 현재 위치 (0) | 2026.08.25 |
| nvidia 그래픽 카드의 정보를 확인하는 방법 (0) | 2026.03.19 |
| 쉽게 배우는 Vision AI 모델 개발(YTube) (0) | 2025.11.03 |