
챗봇은 텍스트를 내놓으면 일이 끝납니다. 로봇은 그 다음이 시작입니다. 피지컬 AI는 이 간극, 즉 "판단한 것을 물리 세계에서 실행하는 부분"을 학습으로 해결하려는 시도입니다.
이 글의 수치와 발표 내용은 모두 원 출처를 함께 표기했습니다. 문단 안의 링크와 맨 아래 참고 자료에서 원문을 확인하실 수 있습니다.
기존 로봇 자동화와 무엇이 다른가
공장의 산업용 로봇은 이미 수십 년째 잘 돌아갑니다. 다만 그 로봇들은 경로를 사람이 지정한 기계입니다. 부품 위치가 몇 센티미터 틀어지거나 조명이 바뀌면 멈춥니다. 환경을 로봇에 맞춰 고정시켜 놓고 쓰는 방식이라, 통제되지 않은 환경으로 나가는 순간 쓸모가 줄어듭니다.
피지컬 AI는 반대 방향입니다. 카메라 영상과 자연어 지시를 입력으로 받아 관절 동작을 직접 출력하는 신경망을 학습시킵니다. 이 구조를 VLA(Vision-Language-Action) 모델이라고 부릅니다. 규칙을 짜는 대신 시연을 보고 배웁니다.
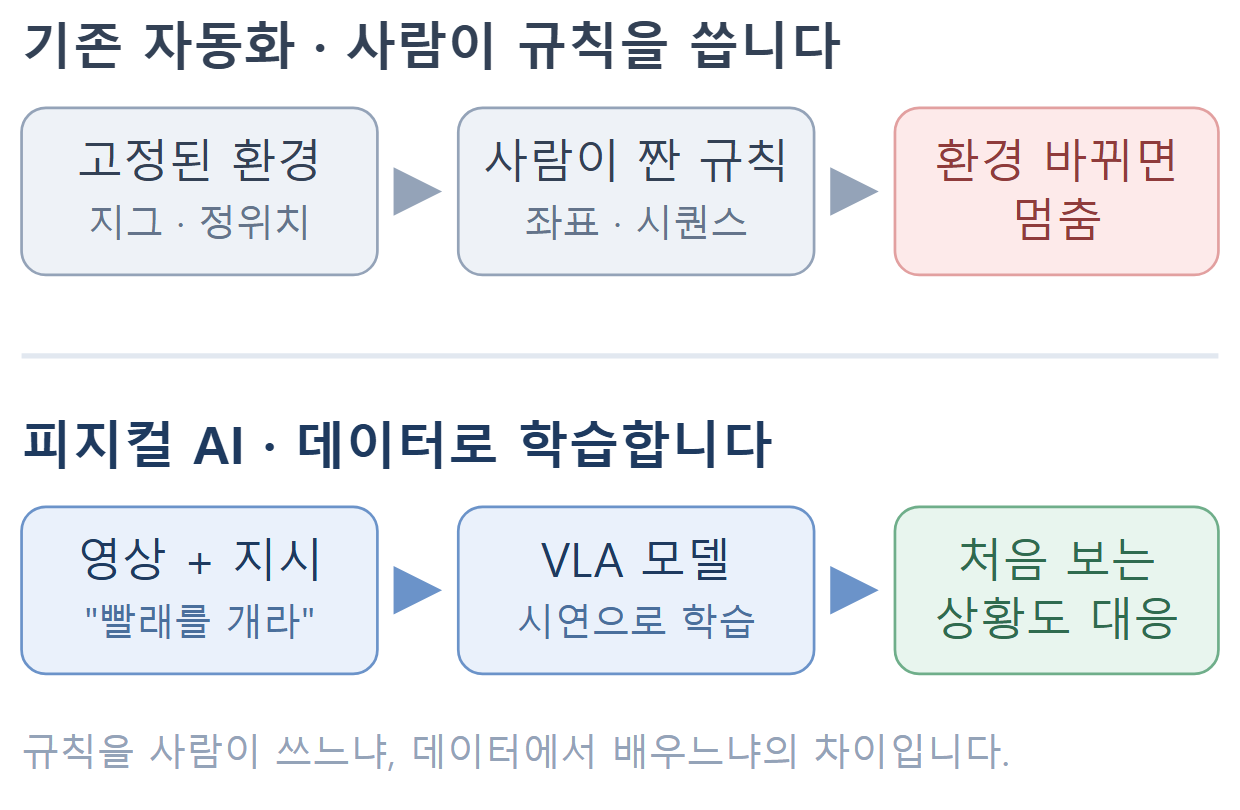
이름을 널리 퍼뜨린 건 엔비디아입니다. 젠슨 황이 CES 2025 기조연설에서 생성형 AI 다음 물결로 피지컬 AI를 지목한 뒤 업계 공용어가 됐습니다.
지금 판을 이끄는 모델들
| 모델 | 주체 | 특징 |
|---|---|---|
| Isaac GR00T N1 계열 | NVIDIA | 최초의 오픈 휴머노이드 파운데이션 모델. 2025년 3월 N1, CES 2026에서 N1.6 |
| π0 / π0.5 | Physical Intelligence | 빨래 개기·식탁 정리 등 장시간 작업. 2025년 2월 가중치 공개 |
| Gemini Robotics 2 | Google DeepMind | 전신 제어와 다중 로봇 협업. 온디바이스 버전 별도 제공 |
| Helix | Figure | 상반신 전체를 제어하는 자체 VLA |
엔비디아는 2025년 3월 GTC에서 Isaac GR00T N1을 "세계 최초의 오픈 휴머노이드 로봇 파운데이션 모델"로 발표했습니다. 최신판인 GR00T N1.6은 30억 파라미터 규모로, 추론 모델 Cosmos Reason을 결합해 모호한 지시를 단계별 계획으로 쪼개는 역할을 맡깁니다.
판단을 담당하는 '느린 뇌'와 관절을 움직이는 '빠른 뇌'를 나누는 이중 구조는 이제 이 분야의 표준 설계에 가깝습니다.
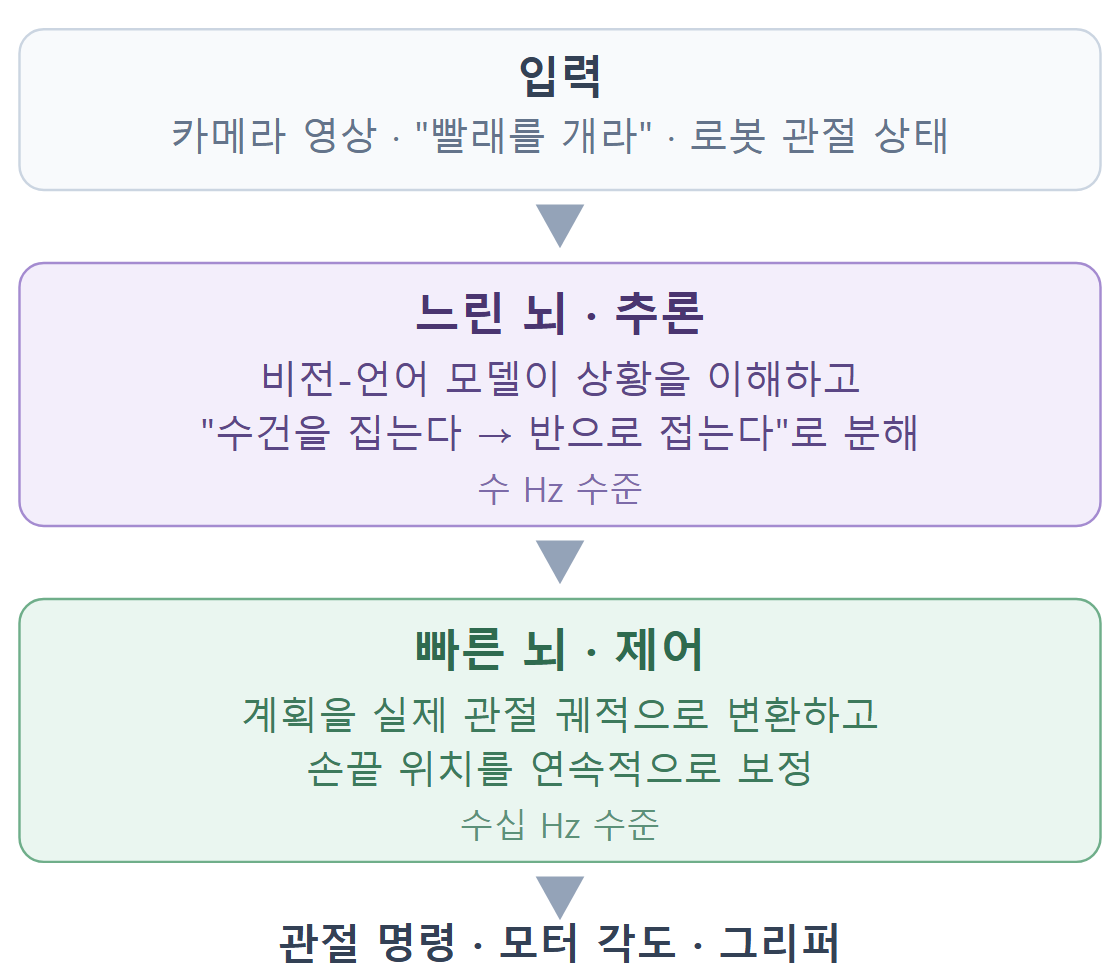
Physical Intelligence는 π0을 "지금까지 가장 유능한 범용 로봇 정책"으로 소개했고, 이후 가중치를 공개했습니다. 구글 딥마인드는 2025년 3월 Gemini Robotics를 처음 공개한 뒤 전신 제어와 다중 로봇 협업을 다루는 Gemini Robotics 2로 확장했습니다.
자금도 몰렸습니다. Physical Intelligence는 2025년 11월 알파벳 CapitalG 주도로 6억 달러를 유치하며 기업가치 56억 달러를 확정했습니다. 2026년 3월에는 110억 달러 규모 후속 논의가 보도됐지만, 확정 발표가 나온 수치는 아직 56억 달러입니다.
진짜 병목은 모델이 아니라 데이터입니다
언어 모델은 인터넷이라는 학습 데이터가 있었습니다. 로봇에는 그런 게 없습니다. 로봇이 무언가를 집어 올리는 동작 데이터는 인터넷에 굴러다니지 않고, 로봇을 직접 움직여야만 생깁니다.
이 분야에서 가장 큰 공개 데이터셋인 Open X-Embodiment는 21개 기관, 34개 연구실이 60개 데이터셋을 모아 만든 것으로, 22종 로봇에서 얻은 100만 건 이상의 실제 로봇 궤적을 담고 있습니다. 이 분야 최대 규모가 그 정도입니다. 대형 언어 모델이 수조 개 토큰을 학습하는 것과 자릿수가 크게 다릅니다.
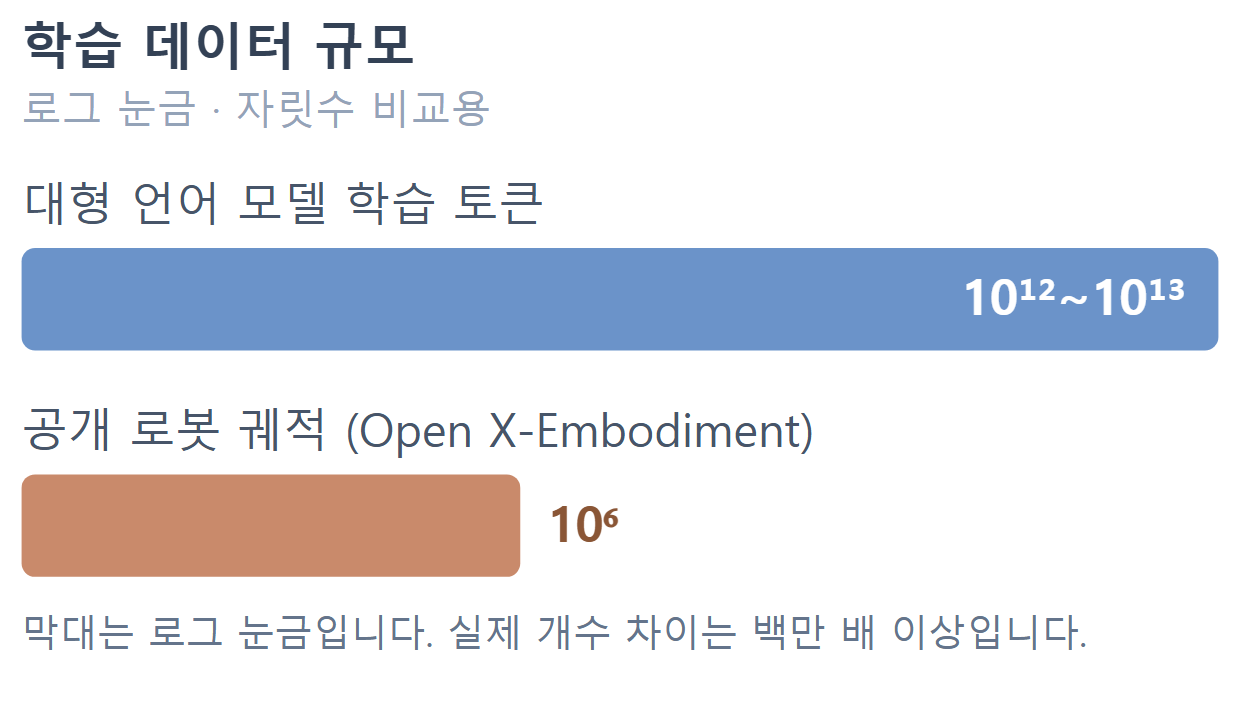
그래서 데이터를 만드는 방법 자체가 경쟁 영역이 됐습니다.
- 원격 조작: 사람이 컨트롤러로 로봇을 직접 조종해 시연을 쌓습니다. 품질은 가장 좋지만 사람 시간이 그대로 비용입니다.
- 시뮬레이션: 가상 환경에서 수만 번 반복시킵니다. 싸지만 시뮬레이션과 현실의 물리가 어긋나는 sim-to-real 격차가 남습니다. 엔비디아가 Newton 물리 엔진을 비롯한 로보틱스 오픈 모델과 시뮬레이션 라이브러리를 내놓은 이유입니다.
- 영상 학습: 사람이 일하는 영상에서 배우려는 접근입니다. 데이터는 많지만 관절 각도 같은 정답이 없어 난이도가 높습니다.
학습 데이터를 생성하는 모델이 따로 나온 것도 이 맥락입니다. 엔비디아에 따르면 Cosmos 월드 파운데이션 모델은 300만 회 넘게 내려받혔습니다.
예상 밖의 성과: 크로스 임바디먼트
최근 몇 년 사이 가장 반직관적인 발견은 이것입니다. 여러 종류의 로봇 데이터를 섞어 하나의 모델을 학습시키면, 특정 로봇만을 위해 만든 모델보다 그 로봇에서도 더 잘합니다. 구글 딥마인드는 여러 로봇 종류에 걸쳐 학습을 확장한 결과를 정리하며 이 효과를 보고했습니다.
팔 길이도 관절 수도 다른 기계들인데 데이터가 서로 도움이 됩니다. 물체를 다루는 데 필요한 공통 구조가 있고 모델이 그걸 배운다는 뜻입니다. 로봇마다 처음부터 다시 학습시켜야 한다는 기존 전제가 깨진 셈이고, 그래서 "파운데이션 모델"이라는 표현이 붙었습니다.
냉정하게, 아직 안 되는 것
데모 영상은 화려하지만 현장 기준은 다릅니다.
- 속도: 사람보다 느립니다. 같은 작업을 해내더라도 시간이 더 걸립니다.
- 신뢰도: 대체로 되는 것과 거의 항상 되는 것은 다른 문제입니다. 산업 현장은 후자를 요구합니다.
- 일반화: 학습에서 본 환경과 처음 보는 환경의 성능 차이가 여전히 큽니다.
- 비용: 휴머노이드 한 대 가격이 사람 인건비와 경쟁하려면 아직 멀었습니다.
한스 모라벡이 1988년에 지적한 역설이 그대로 유효합니다. 추론은 쉽고 지각과 운동은 어렵습니다. 어려운 문제를 푸는 모델이 나온 지금도, 처음 보는 싱크대에서 컵을 꺼내는 건 여전히 연구 주제입니다.
국내 상황
정부가 2026년 들어 독자 로봇 파운데이션 모델과 월드모델 원천기술 확보를 국책 과제로 추진하고 있습니다. 방향은 맞지만, 위에서 본 것처럼 이 분야의 승부처는 모델 구조보다 데이터 확보 체계입니다. 제조 현장 데이터가 많다는 건 국내의 실질적 자산이고, 그걸 학습 가능한 형태로 바꾸는 쪽에 투자가 붙는지가 관전 포인트입니다.
직접 만져보고 싶다면
읽는 것보다 돌려보는 게 빠릅니다. GR00T와 π0 계열은 가중치가 공개돼 있어 Hugging Face에서 바로 받을 수 있고, 로봇이 없어도 시뮬레이터에서 정책을 돌려볼 수 있습니다. 공개 데이터셋을 불러와 학습 루프를 한 번 굴려보면, 이 분야의 병목이 왜 데이터인지 몸으로 이해하게 됩니다.
참고 자료
- NVIDIA, Isaac GR00T N1 발표 (2025-03)
- NVIDIA, GR00T N1.6 sim-to-real 워크플로 기술 블로그
- NVIDIA, 로보틱스 오픈 모델·시뮬레이션 라이브러리 발표 (Newton, Cosmos)
- Physical Intelligence, π0: Our First Generalist Policy · 논문 arXiv:2410.24164 · Open Sourcing π0 · π0.5
- Google DeepMind, Gemini Robotics 최초 공개 · Gemini Robotics 2 · On-Device
- Open X-Embodiment 프로젝트 페이지 · 논문 arXiv:2310.08864 · DeepMind 해설
- The Elec, Physical Intelligence 기업가치 관련 보도
- ZDNet Korea, 피지컬AI 핵심기술 국산화·독자 로봇 파운데이션 모델
본문의 도해 세 개는 개념 설명을 위해 직접 그린 것으로, 특정 제품의 실제 아키텍처 도면이 아닙니다.
'인공지능 AI' 카테고리의 다른 글
| 젯슨 나노 피지컬 AI 1부 - 보드 선택과 실시간 검출 (0) | 2026.09.08 |
|---|---|
| AI 모방학습 준비와 절차 - LeRobot 기준 (0) | 2026.08.28 |
| nvidia 그래픽 카드의 정보를 확인하는 방법 (0) | 2026.03.19 |
| 쉽게 배우는 Vision AI 모델 개발(YTube) (0) | 2025.11.03 |
| AI머신비젼 외관검사의 트렌드 2024 (0) | 2025.11.03 |